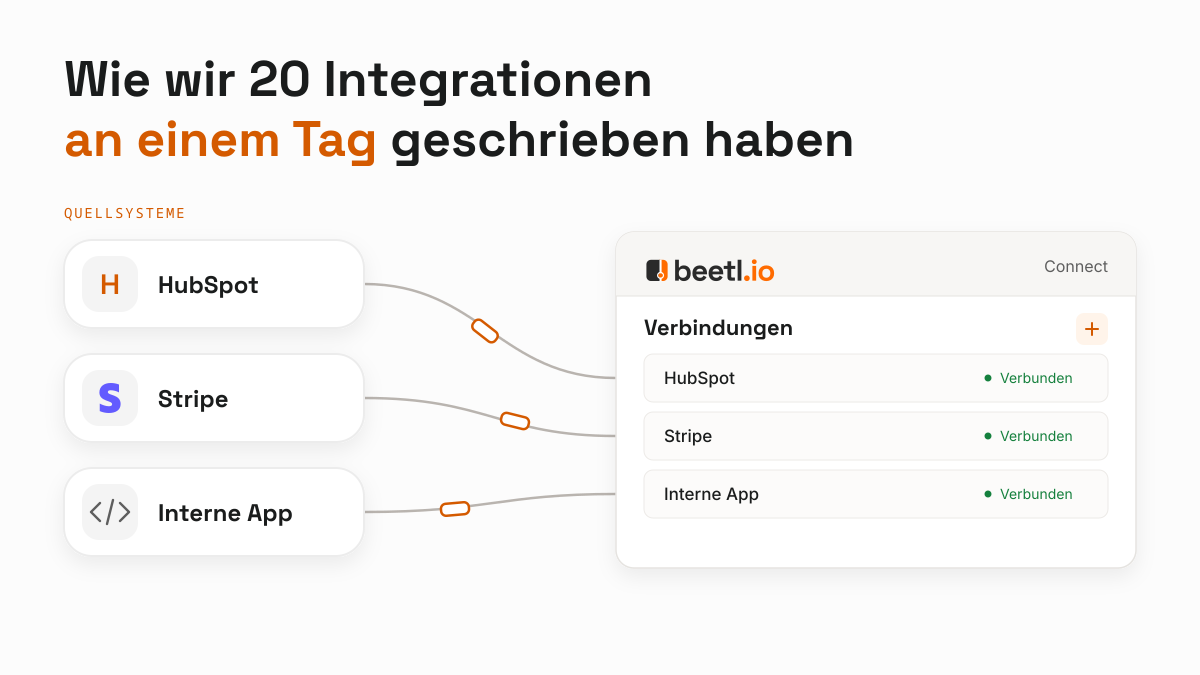
Wir wollten, dass Beetl-Nutzer ihre Geschäftsanwendungen verbinden und die Daten gemeinsam auswerten können. Zum Beispiel Deals aus HubSpot mit Rechnungen aus der Buchhaltung abgleichen.
Zuerst müssen wir diese Daten in Beetl bekommen. Dafür haben wir Beetl Connect gebaut: ein Toolkit, das den Code zum Abrufen der Daten klein hält. Um die Ausführung kümmert sich unsere Plattform.
Mit Connect bauen wir fertige Integrationen für unseren Katalog und können schnell individuelle Varianten für einzelne Kunden entwickeln. Etwa um eine interne Anwendung anzubinden oder Daten so abzurufen, wie ein bestimmter Kunde sie braucht. Beides nutzt dasselbe Toolkit und läuft auf derselben Infrastruktur.
Mit Connect und einem Coding Agent haben wir an einem Tag 20 Integrationen geschrieben und erste Tests durchgeführt. An HubSpot lässt sich gut zeigen, wie wir dabei vorgegangen sind.
Eine gemeinsame Struktur für Integrationen
export default defineIntegration({
  key: "hubspot",
  displayName: "HubSpot",
  connection: {
    origin: "https://api.hubapi.com",
    auth: auth.bearer(),
  },

  syncs: (defineSync) => ({
    pipelines: defineSync({
      displayName: "Pipelines",
      mode: "replace",
      records: storageRecord(Pipeline),

      async *run(ctx) {
        yield* batchRecords(
          (async function* () {
            for (const objectType of ["deals", "tickets"]) {
              for await (const records of pages(
                ctx,
                `/crm/pipelines/2026-03/${objectType}`,
                Pipeline.omit({ objectType: true }),
              )) {
                yield* records.map((record) => ({...record, objectType,}));
              }
            }
          })(),
        );
      },
    }),
  }),
});
Das ist ein gekürzter Ausschnitt unserer HubSpot-Integration. Er zeigt den Sync für Sales- und Support-Pipelines. Imports, Datensatzdefinitionen und Hilfsfunktionen haben wir hier weggelassen.
Wir haben uns für TypeScript entschieden, weil es so weit verbreitet ist, und unsere SDK darauf aufgebaut.
Die Deklaration auth.bearer() sagt Beetl, dass es nach einem Bearer Token fragen soll. Die SDK weiß dadurch auch, wie es den Token bei Requests an HubSpot mitsendet. Daraus entsteht das Eingabe-Formular im Screenshot.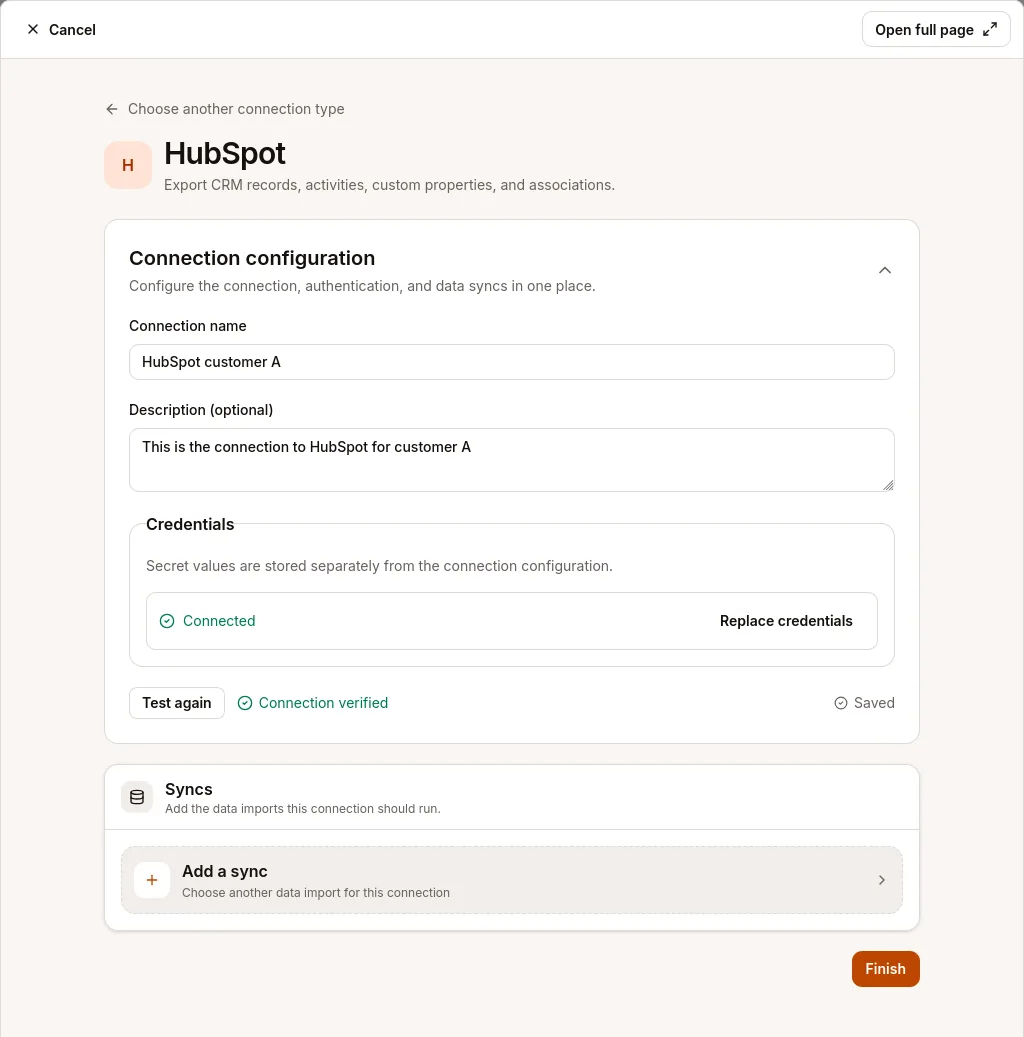
Die Deklaration records beschreibt, welche Daten der Sync liefert. Pipeline definiert hier Felder wie den Namen einer Pipeline und ihre Phasen. Mit mode: "replace" ersetzt jeder erfolgreiche Run den vorherigen Export in Beetl. Für inkrementelle Syncs gibt es außerdem die Modi "append" und "merge".
Die Funktion run ruft die Daten ab. Unser pages-Helper kümmert sich dabei um HubSpots Pagination, also darum, alle Seiten einer Antwort abzuholen. Beetl übernimmt Zeitplan und Speicherung. Kontakte und Deals haben eigene Syncs. So lassen sie sich zu unterschiedlichen Zeiten aktualisieren und teilen sich trotzdem dieselbe Verbindung.
Welche Daten holen wir ab?
Mit einer Liste von Deals können wir anfangen. Um sie mit Rechnungen abzugleichen, möchten wir aber auch wissen, zu welchem Unternehmen ein Deal gehört. HubSpot nennt diese Verknüpfungen Associations. Unsere Integration bietet dafür einen eigenen Sync. Er erhält die Verknüpfungen samt Labels, damit sich ein Deal bis zum Unternehmen und den beteiligten Personen zurückverfolgen lässt. Nutzer können auswählen, welche Datensatztypen sie einbeziehen möchten.
Neben den Geschäftsdaten holen wir auch die zuständigen Personen (Owners), Pipeline-Definitionen und Feldbeschreibungen ab. Zusammen sind das 16 Syncs, die sich dieselbe HubSpot-Verbindung teilen.
Alle Formulare im UI entstehen aus den Eingabeschemas, die wir mit Zod in der Integration definieren. Unsere Plattform muss dafür nur das zugehörige JSON Schema verstehen.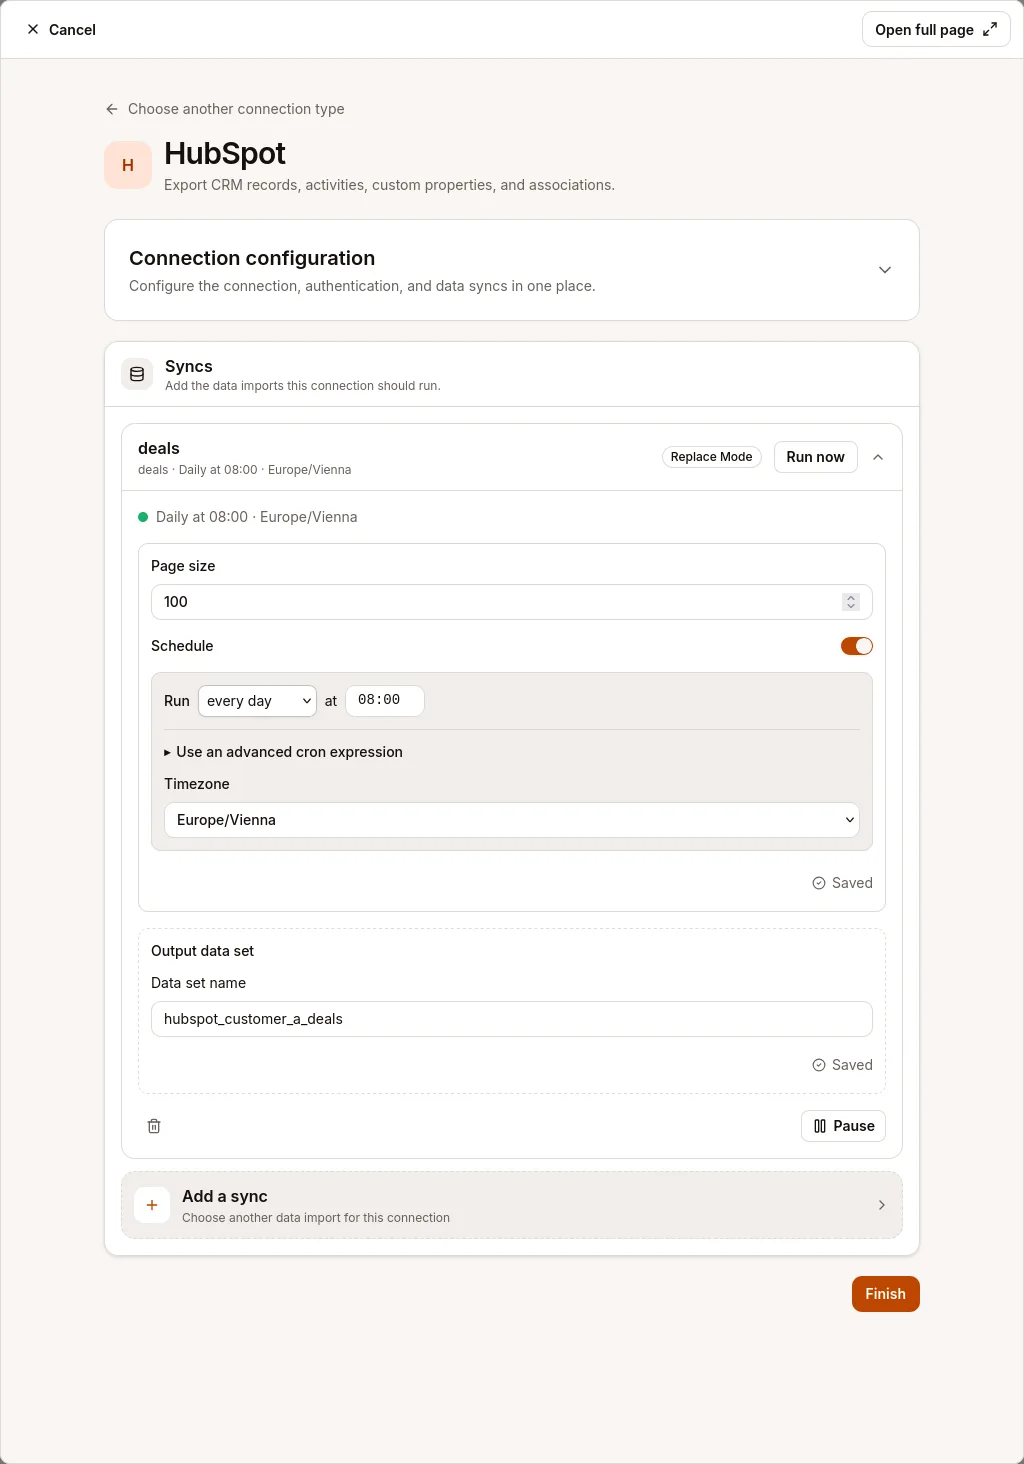
Bevor wir Code schreiben
An der Stelle würde man dem Agent am liebsten einen API-Key geben und ihn einfach loslegen lassen. Vorher müssen wir aber die Bedingungen des Anbieters prüfen. Dazu gehört, ob wir die Integration über unseren Katalog anbieten dürfen und welche Vorgaben für die Markennutzung gelten. Danach können wir einen Entwicklungsaccount einrichten und Zugangsdaten für die Tests besorgen.
Wir legten fest, welche Syncs dazugehören sollten. Der Agent las die API-Dokumentation und erarbeitete, mit welchen Einstellungen unterschiedliche Nutzer die Integration an ihre Bedürfnisse anpassen können.
Mit diesem vereinbarten Umfang schrieb und paketierte der Agent die Integration, lud sie in Beetl hoch, führte die Syncs aus und sah sich die entstandenen Datasets an. Anhand der Ergebnisse korrigierte er den Code und probierte es erneut.
Danach waren wir mit dem Code Review dran. Wir lasen den Code, testeten die Syncs selbst und verglichen die importierten Datensätze mit HubSpot.
Das Ganze dann für alle 20 Integrationen.
Die Integration testen
Ein Vertriebsteam ergänzt seine HubSpot-Kontakte vielleicht um ein Feld namens "Customer tier". Unsere Integration liest die Felddefinitionen des Accounts aus und ruft die zugehörigen Werte ab. So können Kunden ihre eigenen Felder mit derselben Integration übernehmen.
Associations haben eine eigene Pagination. Wir testeten Kontakte mit so vielen Verknüpfungen, dass sie über mehrere Antworten verteilt waren. Dabei prüften wir, ob jede Seite gelesen wurde und die Labels der Verknüpfungen im Export erhalten blieben.
Nur kürzlich geänderte Datensätze abzurufen klingt verlockend. Aber was ist mit einem Deal, der gelöscht wurde? Dafür bräuchten wir einen eigenen Mechanismus, der endgültig gelöschte Datensätze und entfernte Verknüpfungen erkennt. Bei diesen Syncs haben wir uns für vollständige Exporte entschieden, die den bisherigen Datenbestand nach einem erfolgreichen Run ersetzen. Schlägt ein Run fehl, bleibt der letzte erfolgreiche Stand in Beetl verfügbar.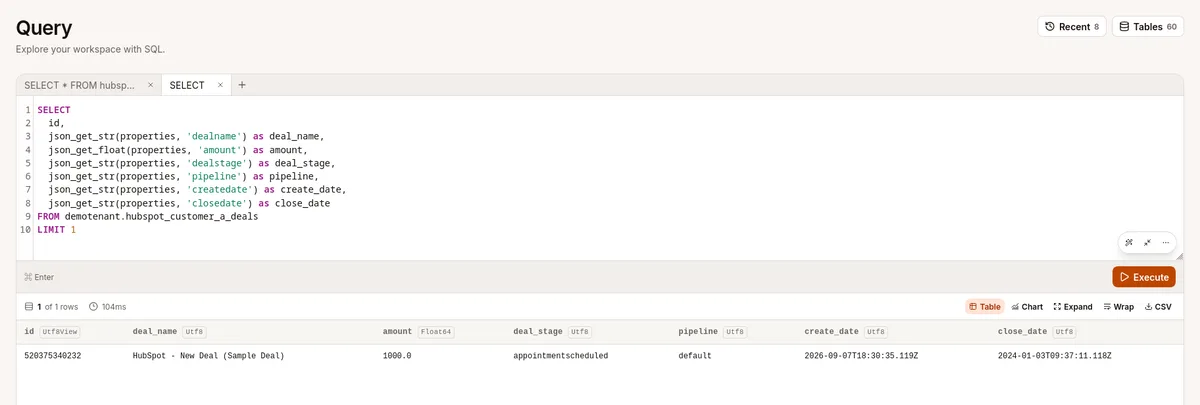
Code unserer Nutzer ausführen
Wenn Nutzer eigene Integrationen hochladen können, läuft fremder Code auf unserer Infrastruktur. Und was hält den davon ab, dort herumzustöbern, wo er nichts verloren hat? Wir müssen mit fehlerhaftem und auch mit absichtlich bösartigem Code rechnen.
Wir nutzen gVisor auf Kubernetes, um jeden Job in einer neuen, isolierten Umgebung auszuführen. Speicherverbrauch und Laufzeit sind begrenzt. Builds bekommen denselben Schutz, denn schon beim Laden eines Pakets kann Code ausgeführt werden.
Der Netzwerkzugriff wird außerhalb des Jobs kontrolliert. Der Job kann einen dafür vorgesehenen Beetl-API-Endpoint und einen Envoy-Proxy erreichen. Dafür nutzt er kurzlebige Zugangsdaten, die nur für diesen Run gelten. Der Proxy erlaubt öffentliche HTTPS-Verbindungen, während der Zugriff auf private Infrastruktur gesperrt bleibt.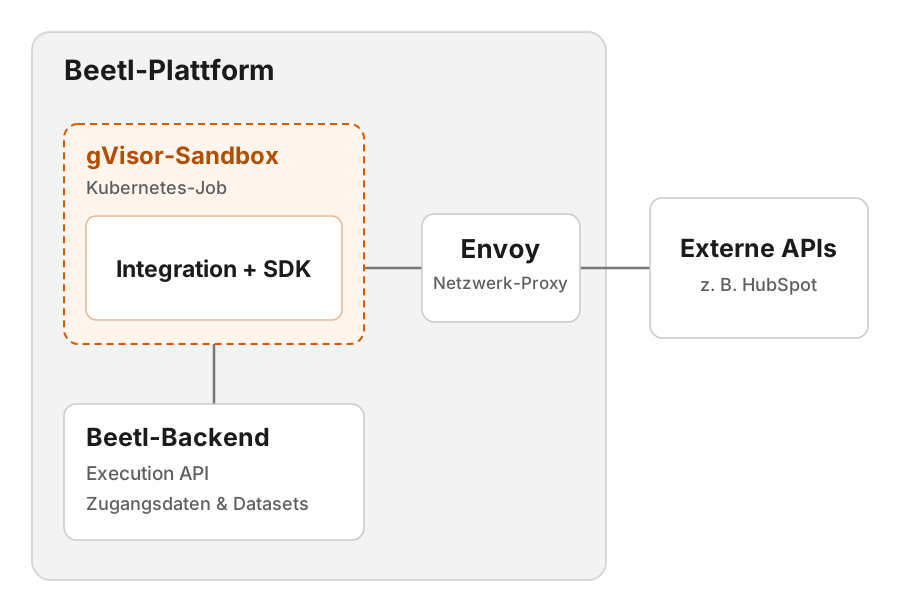
Die Integration erhält die Zugangsdaten ihrer ausgewählten Verbindung. Wer den Account verbindet, muss dem Code also vertrauen. Die Zugangsdaten anderer Verbindungen und der Plattform bleiben außerhalb des Jobs.
Über den Proxy können wir später auch einzelne Syncs per VPN mit privaten Kundennetzwerken verbinden, etwa mit Tailscale/Headscale oder einem anderen Anbieter.
Zugangsdaten und Speicherung gemeinsam lösen
Die Verwaltung von Zugangsdaten und die Datenspeicherung haben wir in Beetl eingebaut, damit jede Integration sie nutzen kann. Die Plattform kümmert sich um gespeicherte Zugangsdaten und erneuert den Zugriff, wenn der Anbieter das unterstützt.
Die Integration holt die Daten, Beetl prüft und speichert die Ergebnisse. Schlägt ein Export fehl, bleibt der letzte erfolgreiche Datenbestand verfügbar. Wer eine Integration schreibt, hat damit eine überschaubare Aufgabe: die richtigen Daten aus der Quellanwendung holen. Den Rest übernimmt die Plattform.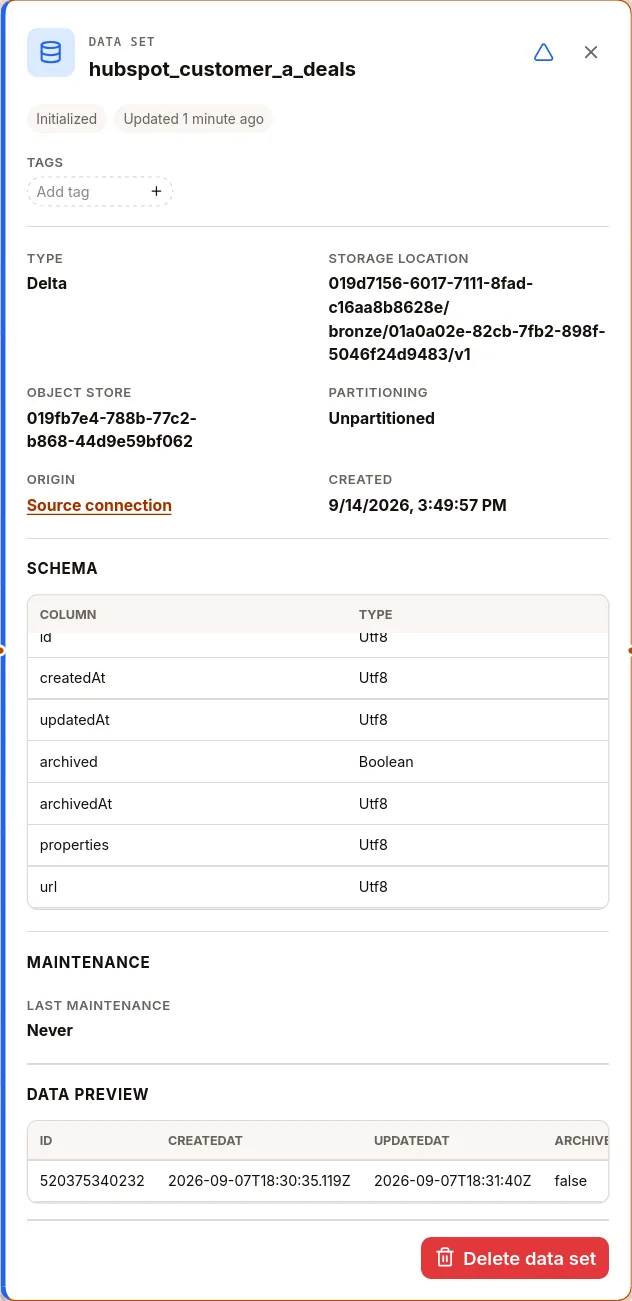
Warum das mit KI funktioniert hat
Alle 16 HubSpot-Syncs passen in 397 Zeilen TypeScript, inklusive Datensatzdefinitionen und Leerzeilen. Connect liefert die gemeinsamen Bausteine, Beetl die Infrastruktur für die Ausführung.
Damit hatte der Coding Agent eine überschaubare Aufgabe. Er konnte sich an der API-Dokumentation und einer bestehenden Integration orientieren, seinen Code ausführen und die Ergebnisse ansehen. Wir konnten uns beim Review darauf konzentrieren, wie er mit den Quelldaten umgeht.
Mit der fertigen SDK und der Ausführungsplattform haben wir an einem Tag 20 Integrationen geschrieben und erste Tests durchgeführt. So schnell ging das, weil wir diese Grundlage für alle Integrationen wiederverwenden konnten. Die KI half uns dabei, den Code für die jeweilige Anwendung zu schreiben und zu testen.
Das verändert auch unseren Umgang mit unterschiedlichen Kundenanforderungen. Eine allgemeine HubSpot-Integration kann mit der Zeit allerlei Einstellungen und Ausnahmen ansammeln, um unterschiedliche Setups abzudecken. Beim nächsten Wunsch liegt es nahe, einfach noch eine Einstellung hinzuzufügen. Mit Connect können wir einem Kunden mit besonderen Anforderungen auch eine kleine eigene Integration bauen. Das kann günstiger sein, als eine weitere Ausnahme im gemeinsamen Connector unterzubringen, weil SDK und Infrastruktur bereits vorhanden sind.
Kunden können solche Integrationen auch selbst schreiben. Die SDK ist Open Source. Sie können also eine bestehende Integration anpassen oder eine für ihre eigene Anwendung entwickeln. Wir können das auch für sie übernehmen. Ihre individuelle Integration läuft in jedem Fall auf derselben Plattform wie die Integrationen aus unserem Katalog.
Wenn Ihr Team mit den Integrationsanfragen kaum hinterherkommt, helfen wir gerne. Schreiben Sie uns an info@beetl.io, was Sie verbinden möchten.
Dieser Artikel ist unabhängig von HubSpot, Inc. und wird von HubSpot weder unterstützt noch gesponsert oder genehmigt. Die Bedingungen des Anbieters wurden am 14. September 2026 geprüft.